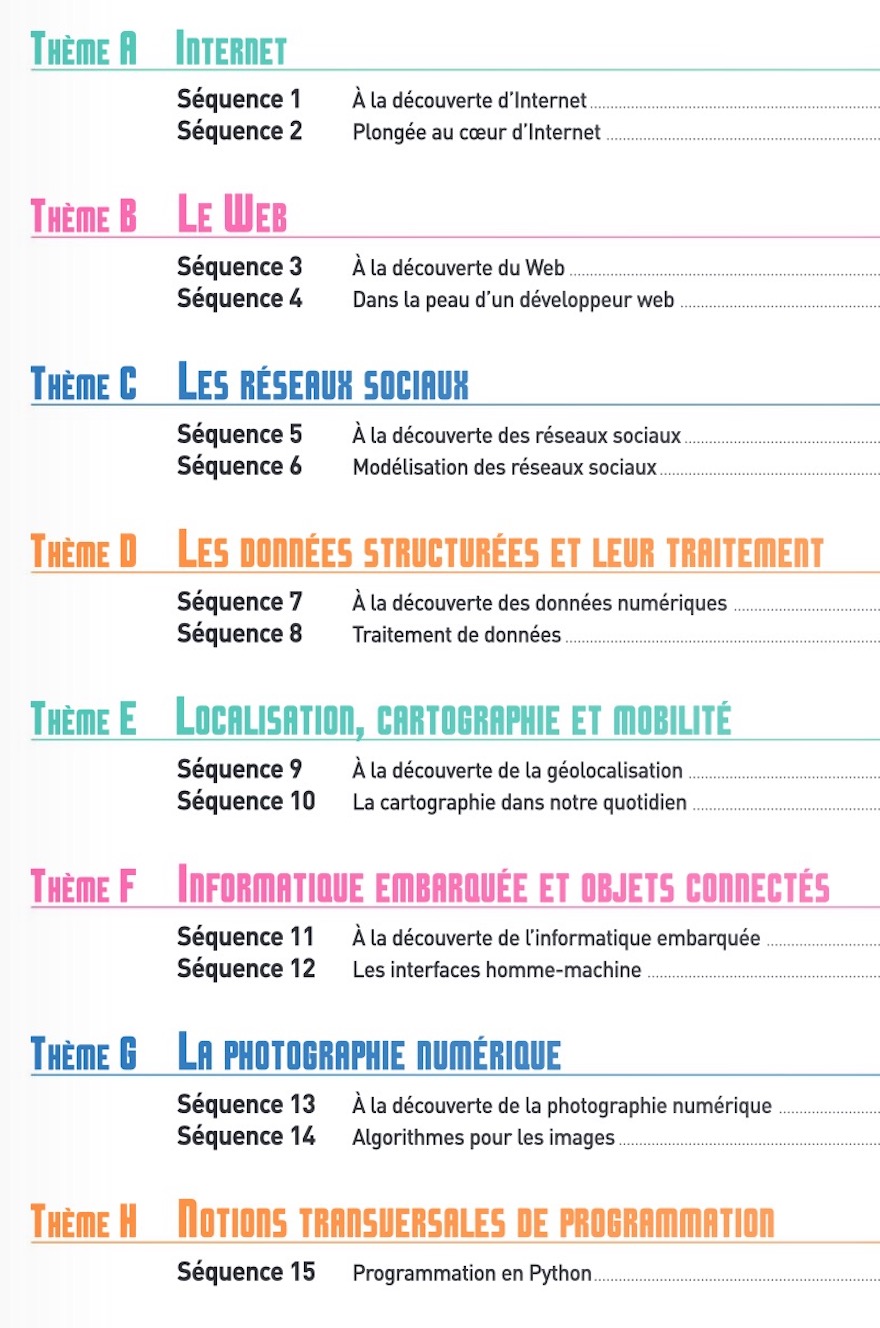
Téléchargez le document ci-dessous, ouvrez-le dans un lecteur PDF (Adobe Reader, Sumatra PDF, Apple Preview…) puis tapez Ctrl-L pour le passer en plein écran. Déroulez les étapes avec la flèche droite et dégustez.
Category: Uncategorized
-
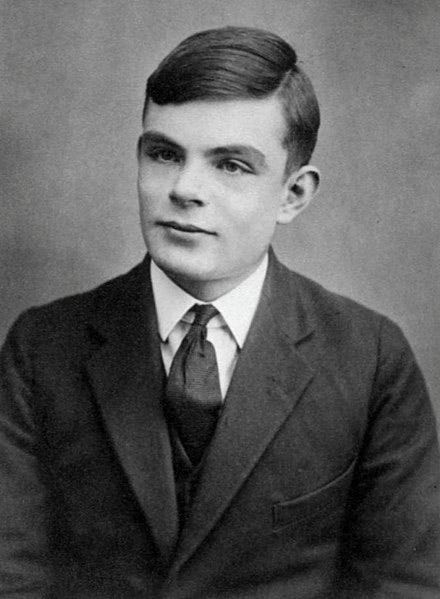
Alan Turing, run!
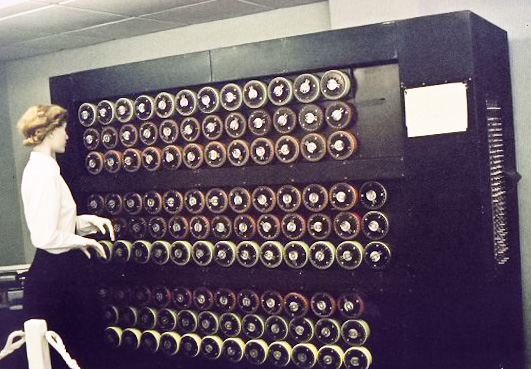
La course est au centre de la vie d’Alan Turing, le mathématicien génial qui a permis de casser des codes secrets pendant 2ème Guerre Mondiale, imaginé un test ultime pour les IA et conçu les plans d’une machine à calcul universelle.
-
EDEN#3 [:;,?!@]
La confidentialité est au coeur de la cybersécurité.
Avant de l’étudier en détail, replaçons-la dans le contexte général de la sécurité sur Internet.
On distingue 2 catégories de sécurité :
- la protection contre les attaques
- la confidentialité des données.
La protection consiste à empêcher les attaques qui peuvent de plusieurs types :
- le vol de données
- la destruction de données
- la perte d’accès à des données ou des applications ou des sites.
La confidentialité consiste à empêcher un tiers de lire les données ou les messages dans leur forme originale. Par exemple le protocle https crypte les données sur le réseau Internet; elles peuvent être interceptées, mais l’algorithme de chiffrage les rend incompréhensibles donc inutilisables.
Dans cet atelier nous nous sommes intéressés au fonctionnement du réseau Internet pour identifier quand et à quel niveau la sécurité peut être assurée.
Puis nous avons détaillé un exemple célèbre de déchiffrement réussi (qui a donc réussi à briser la confidentialité) : la “casse“, par Alan Turing et son équipe, des codes Enigma utilisés pendant la 2ème guerre mondiale.
-
EDEN#2 Info(x)
Nous avons abordé la fiabilité des sources d’information sur Internet.
Après avoir cité des cas d’école de sources biaisées (comme la revente des données personnelles d’utilisateurs Facebook en 2016 à l’équipe américaine du parti conservateur américain pour l’élection présidentielle), nous avons cherché à identifier des sources fiables d’information.
D’abord, 3 critères pour évaluer la fiabilité d’une information :
- l’auteur : qui l’a écrite ?
- la source : qui l’a publiée / retransmise / postée ? ce peut être un journal, un site, un ami, un contact…
- l’enjeu : quel intérêt l’auteur et / ou la source peut avoir à publier cette information ? il peut s’agir d’un intérêt financier, d’une volonté de pouvoir, d’influence, de se mettre en valeur, etc. ou tout simplement de mettre en avant un produit, ou de s’attirer du trafic pour placer des publicités.
Wikipedia est un bon contre-exemple d’intox : sa fiabilité a été longuement étudiée et a conduit à la conclusion que son taux d’erreur est parmi les plus faibles parmi les sources d’information en ligne. Pour y voir plus clair, examinons les 3 critères précédents :
- l’auteur : n’importe qui peut être auteur sur Wikipedia, on ne demande aucun diplôme ou compétence particulière.
- la source : le texte d’un article et publié sur le site de wikipedia.org et est relu par tous les internautes qui le souhaitent, pour satisfaire les exigences de qualité de contenu : citer les sources utilisées, argumenter les affirmations, viser une neutralité des propos, etc.
- l’enjeu : il n’y a pas d’enjeu financier puisque les auteurs ne sont pas rémunérés. La source (c’est-à-dire la plateforme Wikipedia) n’est pas rémunérée non plus au-delà d’une équipe très réduite. Il n’y a pas non plus d’enjeu de pouvoir ni d’influence, ou en tout cas s’ils existent, ils s’annulent successivement en fonction des auteurs successifs. Sans argent à la clé ni buzz ni profil d’influenceur, il faut chercher l’enjeu ailleurs : il réside principalement dans la volonté des auteurs de publier et rendre accessible un savoir établi, argumenté et sourcé. Contrairement à l’intuition un peu rapide que l’accès à tous rendrait le site moins fiable, c’est précisément le contraire qui se produit.
Soyons clair : il ne s’agit pas d’identifier des sources d’informations “parfaites” : elles n’existent pas. Mais en se posant la triple question auteur / source / enjeu, on peut déjà se faire une bonne idée du biais éventuel de l’information en question.
Nous avons ensuite identifié et commenté des sites et revues très utiles :
- theguardian.com
- Courrier International
- Alternatives Economiques
- Le Monde Diplomatique
- Le Canard Enchaîné
Pour cela nous avons identifié pour chacune, leur modèle économique et donc l’enjeu éventuel lié à la publication d’un article dans ces revues.
Enfin nous avons mentionné des équipes de journalistes spécialement créées pour évaluer la fiabilité d’informations qui font le buzz du moment. Ainsi le site des Décodeurs du Monde ou Checknews de Libération.
-
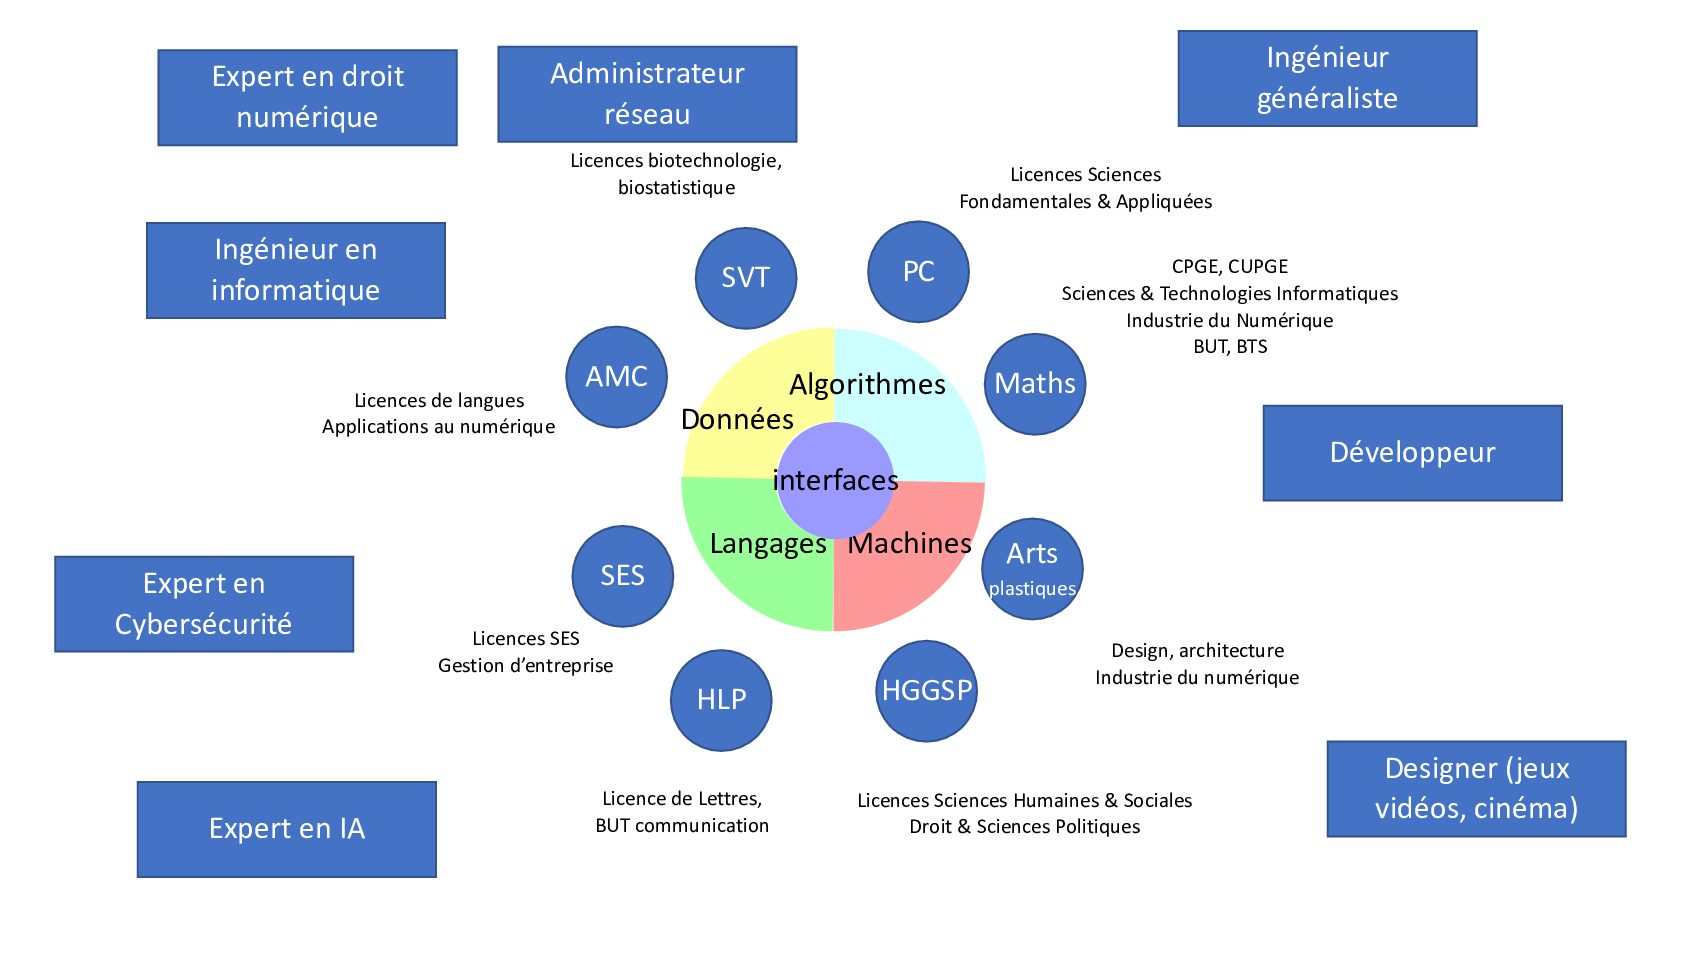
CPGE
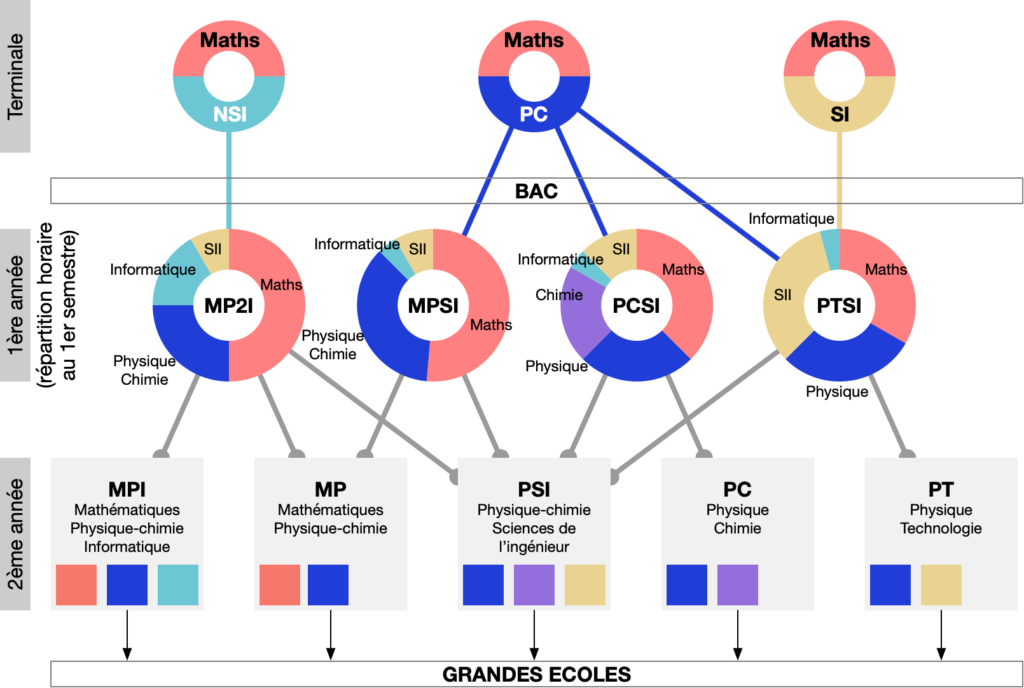
Une infographie maison qui présente les classes préparatoires aux grandes écoles (CPGE) et leurs particularités, ainsi que les parcours possibles.
-
EDEN#1: IA&Co
Pour le lancement d’EDEN nous avons abordé le sujet qui est sur toutes les lèvres : ChatGPT.
D’abord un rappel de l’histoire de l’intelligence artificielle : c’est un terme qui désigne la réunion qui a eu lieu à Dartmouth (USA) à l’été 1956, de spécialistes de logique, de psychologie et de mathématiques. Leur ambition : créer des machines capables d’accomplir des tâches cognitives, et donc de passer avec succès le test de Turing (en anglais : Imitation Game) popularisé par le mathématicien anglais.
Cette discipline a principalement donné naissance à deux courants de recherche : l’IA symbolique, pour transcrire en règles d’inférence les savoirs experts, et l’IA connexionniste, qui imite les cellules neuronales et leurs connexions. L’approche symbolique a conduit aux systèmes experts, largement utilisés dans les contrôles de processus industriels complexes. L’approche connexionniste, qui permet l’apprentissage par renforcement s’est envolée dans les années 2010 sous le triple effet conjugué de l’augmentation des données d’entraînement, de la puissance de calcul et de la sophistication des algorithmes de réglage des paramètres (la rétropropagation de gradient popularisée par le français Yann Le Cun).
ChatGPT est le dernier avatar de cette lignée connexionniste. Bluffant au premier abord, ce robot conversationnel élabore des réponses détaillées, globales et souvent pertinentes aux questions les plus diverses.
Passé la bonne surprise initiale, on relève peu à peu ses limites, qu’il est bon de connaître :
- sa base d’entraînement date de mi-2021 pour la version gratuite
- les réponses données sont parfois fausses, quel que soit le champ de connaissances exploré. Dans cas il est nécessaire d’être déjà compétent pour le repérer… et le corriger.
- les éléments de réponse sont agrégés dans un français très correct et lisible, ce qui élimine – en apparence – le besoin d’apprendre soi-même à formuler, problématiser, argumenter, déduire et conclure.
-
Elon in [TIME]
Un excellent article de Walter Isaacson, biographe, sur Elon Musk, paru dans le magazine TIME la semaine dernière :
-
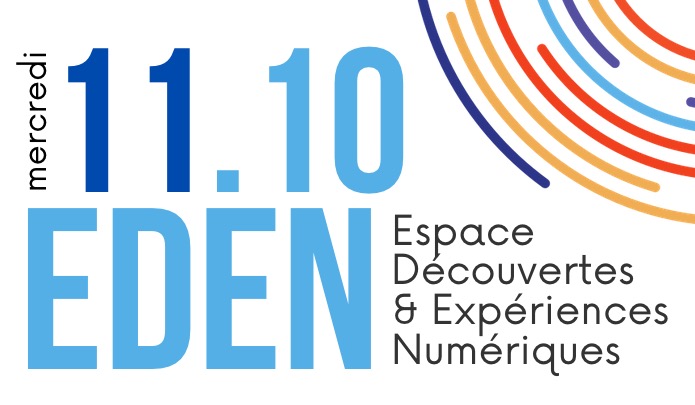
EDEN ouvre!
Pour cette rentrée 2023, le Lycée met en place EDEN, un Espace Découvertes et Expériences Numériques qui permet aux curieuses et aux curieux de s’initier à des technologies très répandues, comme le codage de sites web ou la programmation, ou plus mystérieuses, comme l’intelligence artificielle et ChatGPT.
L’atelier s’adresse en priorité aux élèves de Seconde, mais les Premières et Terminales sont les bienvenues !
C’est aussi une façon de découvrir la spécialité NSI et de répondre à toutes vos questions sur son contenu et les débouchés offerts.
Lieu de partage de bonnes pratiques, cet espace permet de tirer le meilleur des réseaux sociaux tout en connaissant leurs limites.
L’atelier est animé par M. Thierry JURAIN, professeur de SNT et de la spécialité NSI.
La première session aura lieu mercredi prochain le 11 octobre de 14h à 15h30 en salle S103. Venez nombreux !
Pour ceux qui le souhaitent je vous propose de nous retrouver à 13h30 devant la vie scolaire autour d’un panier repas que vous aurez apporté.
-
Project list[TNSI]
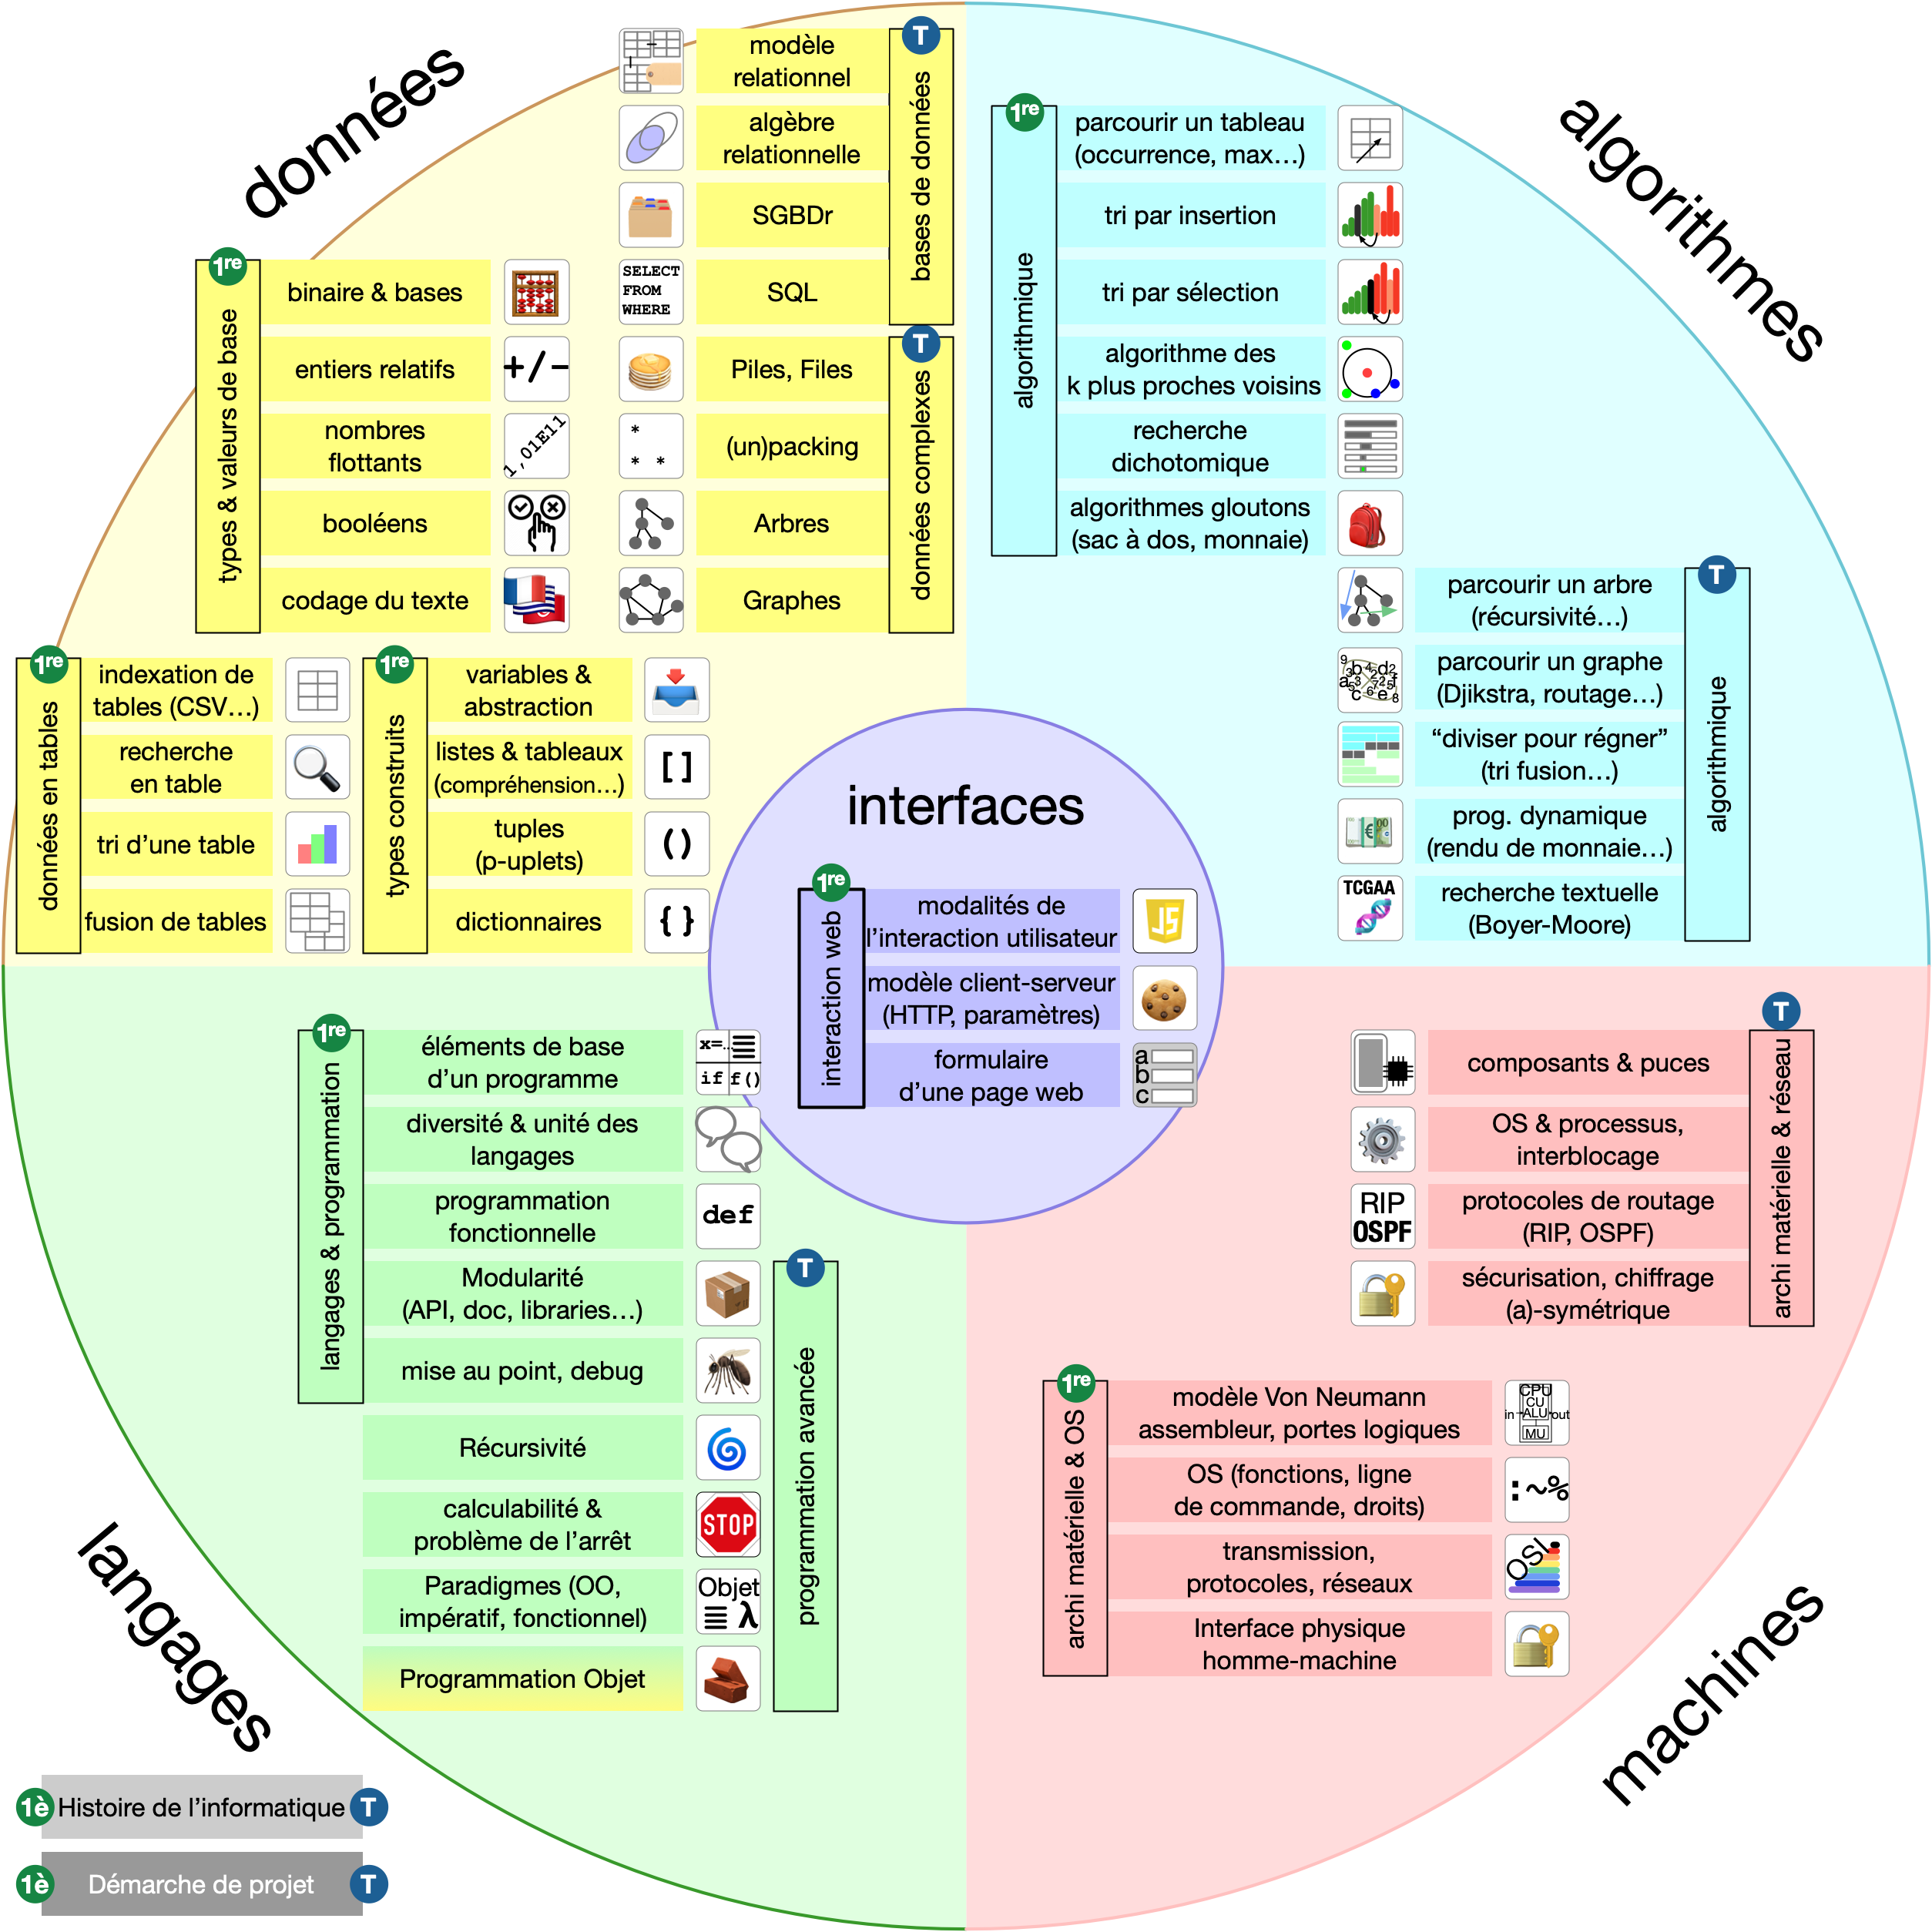
The list is taken from the official NSI program for Terminale :
- LANGUAGES
- “good programming” (modules, doc, tests, debug, style guide)
- Recursivity (“fusion sort”, “divide and conquer”)
- Object-Oriented Programming
- DATA STRUCTURES
- stacks and queues (“piles” et “files”)
- 1ère Round-up : dictionaries, lists, tuples
- Trees
- Graphs : Djikstra algorithm, etc.
- DATA BASES
- Data base design
- SQL (Structured Query Language)
- COMPUTER ARCHITECTURE & OPERATING SYSTEMS
- Computer processes
- Routing protocols
- HTTPS to secure communications
- SPECIFIC ALGORITHMS
- Complexity of an algorithm
- “dynamic programming”
- Search algorithms
- LANGUAGES
-
ChatGPT + ou – …
L’usage du “langage naturel” est connu pour être un atout de ChatGPT.
Mais qu’en est-il si on demande à des experts du langage naturel – des linguistes – d’en juger ?
Une expérience menée dans les états américains de Floride et du Tennessee conclut… qu’on ne peut rien en conclure : des linguistes confrontés à des extraits d’articles académiques ne parviennent pas à distinguer un article écrit par une IA d’un article rédigé par un chercheur humain.
-
Jira team
L’équipe :
- PO Vince + Thomas
- SM Aymeric + Noah
- Dev 1 Vladimir + Maelys
- Dev 2 Van Vinh + Jonathan
- Dev 3 Anthony + Lucas
- Dev 4 Philippe + Sébastien
- Dev 5 Terence + Loïc
- Dev 6 Ryann
- Dev 7 Selim
-
L’épopée OpenAI
Un article des Echos du 4 septembre 2023 relate l’histoire du créateur de ChatGPT… qui a déjà bien changé depuis ses débuts !
-
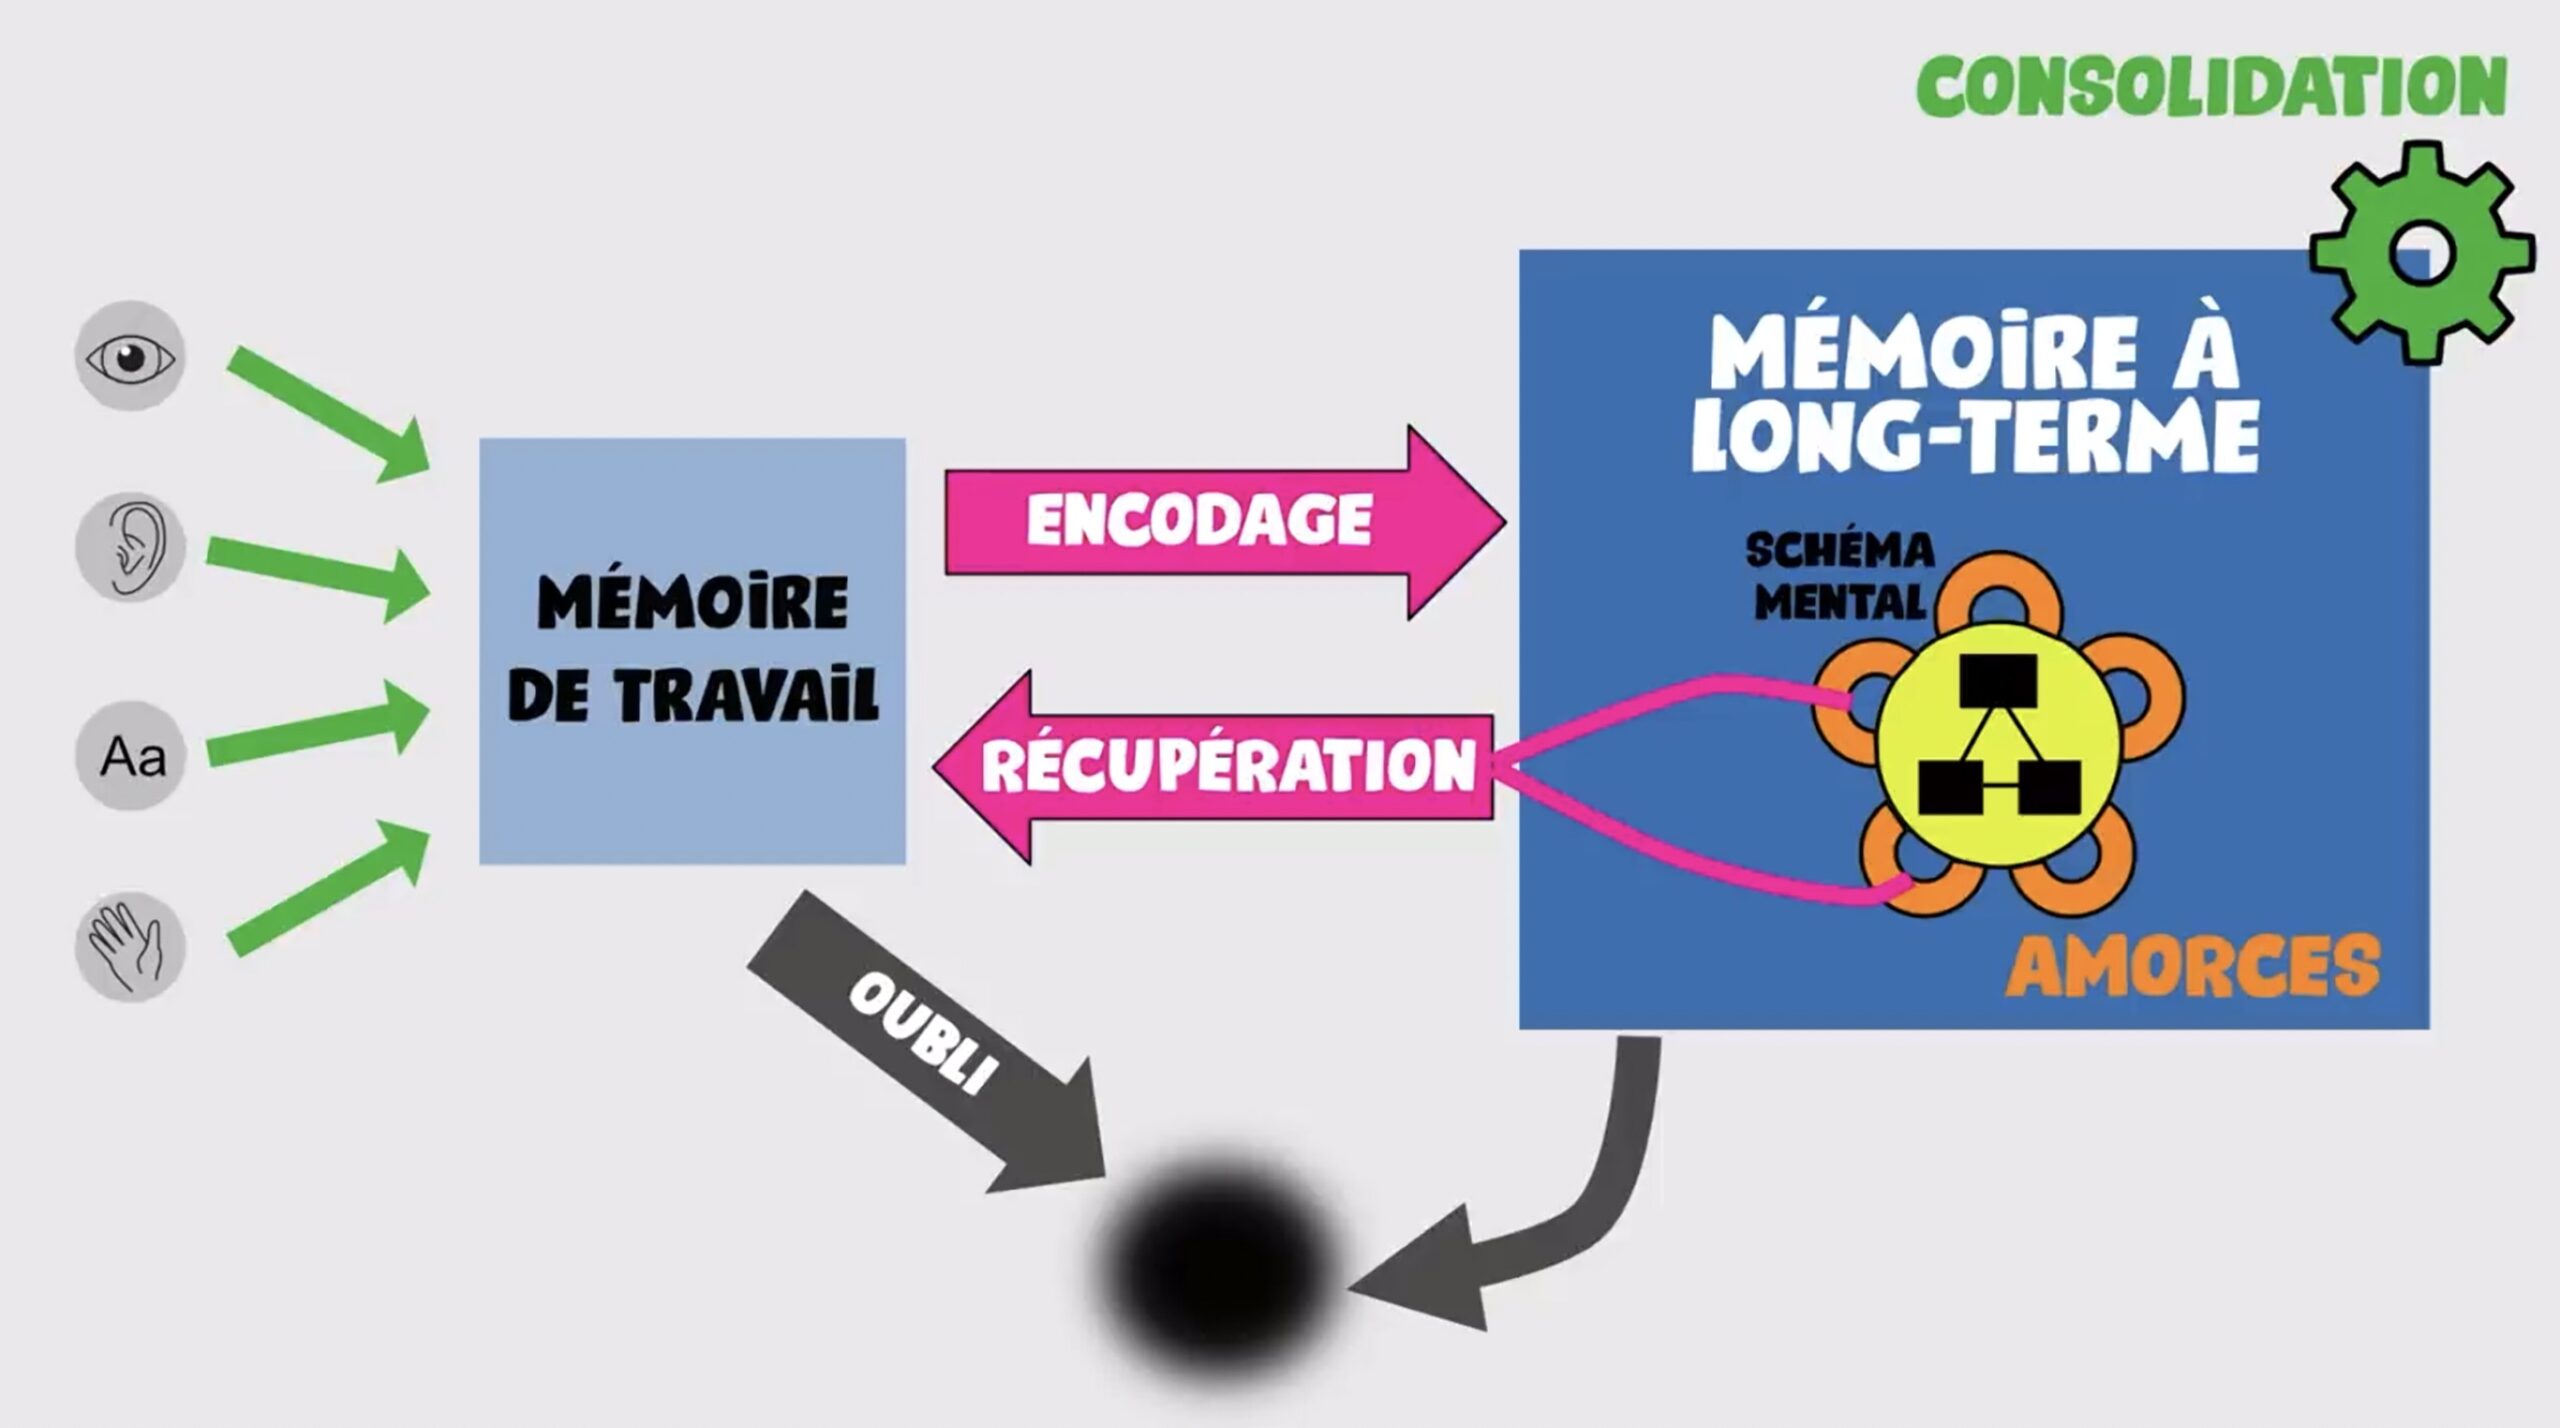
Apprendre mieux
Que dit la science des techniques d’apprentissage et de révision ?
David Louapre en fait une excellente synthèse sur sa chaîne YouTube ici.
Une des techniques présentées, l’apprentissage espacé, est détaillée ici.
-
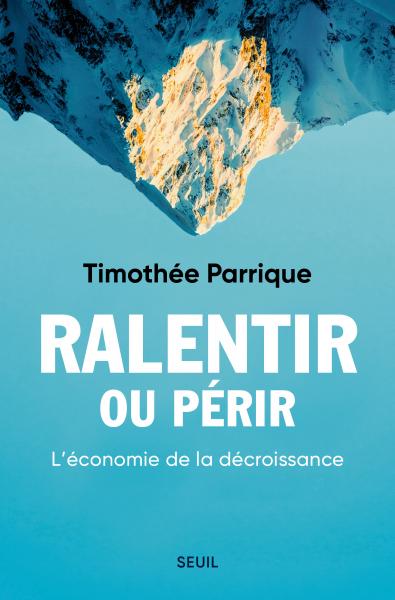
Déconstruire le mythe de la croissance
Le livre Ralentir ou périr de Timothée Parrique démontre la perversité (et l’inanité) de la quête éperdue de croissance (étant définie comme une augmentation du PIB). Mais surtout il décrit et illustre d’autres façons de développer nos sociétés, dans une approche dite de décroissance soutenable (ce que Pierre Rahbi appelle la sobriété heureuse).
-
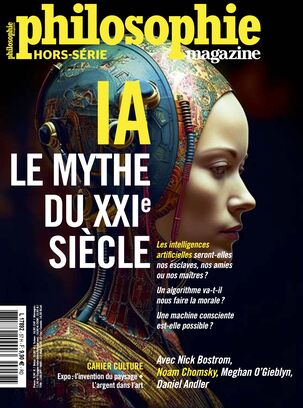
Regards croisés sur l’IA
Une prise de recul salutaire – et pluridisciplinaire – sur l’IA à l’heure de ChatGPT.
-
Ressources : l’eau
L’eau suit un cycle fermé qui change peu la masse totale d’eau en circulation sur notre planète. Et pourtant on lit un peu partout que “le réchauffement climatique rend l’eau plus rare”. Comment est-ce possible ?
La réponse se trouve (entre autres) ici.
Et voici une vue plus complète du cycle complet de l’eau, qui tient compte de son détournement pour les activités humaines.
Source : Sciences & Avenir #917, Juillet-août 2023.
-
ChatGPT et autres perroquets stochastiques
J’ai écrit l’article qui suit pour Le Mag #4 du réseau Avignon d’établissements scolaires, disponible ici (pages 17-19).
Le “perroquet stochastique”
C’est le nom donné par Timnit Gebru, Emily Bender, Angelina McMillan-Major et Shmargaret Shmitchell, des chercheuses américaines, à des modèles de langage de plus en plus volumineux capables de produire du texte de bonne qualité selon des critères de probabilité mais sans en comprendre le sens. De façon plus neutre on parle d’ “IA générative”.
L’avatar le plus récent – et déjà le plus connu – de cette lignée est sans nul doute ChatGPT, un agent conversationnel disponible en ligne (et gratuitement sur l’Apple Store depuis le 18mai 2023), capable de répondre de façon convaincante à des questions de connaissances sur le monde telles que “pourquoi le ciel est-il bleu ?”, “rédige une note d’une page sur la vie de Maupassant”, ou bien “explique à un enfant de dix ans, en espagnol et avec quelques fautes d’orthographe, le fonctionnement d’un ordinateur quantique”.
6 mois seulement après sa disponiblité par l’entreprise OpenAI en novembre 2022, plus de 200 millions de personnes dans le monde l’utilisent régulièrement. Ce succès a accéléré les travaux dans ce domaine par les géants du net (GAFAM – Google, Apple, Facebook-Meta, Amazon, MIcrosoft), dans une course à l’armement technique en termes d’IA générative.
Une IA générative est un programme informatique capable d’identifier des traits distinctifs dans des données fournies (par exemple les mots d’une question), d’associer un contenu déjà archivé à chacun de ces traits (par exemple un article de presse ou une image), et de les combiner pour produire un tout cohérent (par exemple une argumentation de 2 pages). Le procédé qui l’implémente est appelé réseau de neurones artificiels, en ce qu’il s’inspire de la façon dont nos propres neurones élaborent des connexions qui se renforcent par apprentissage.
Concrètement, notre perroquet s’appuie sur :
- un ensemble gigantesque d’échantillons de textes, ou bien d’images, de sons ou de vidéos, que l’on appelle des entrées; ce peut être également des relevés de mesure, ou tout type de données dont l’on souhaite extraire des traits caractéristiques. Ces données sont codées numériquement pour se prêter à des calculs.
- des fonctions mathématiques, qui effectuent une pondération des entrées en plusieurs étapes ou couches. Les pondérations ne sont pas fixes, elles évoluent pour corriger les erreurs sur les cas connus.
- un processus d’apprentissage, qui nourrit le modèle avec des “exercices corrigés”, c’est-à-dire des questions accompagnées de leur réponse.
Chacun de ces éléments constitue un axe d’amélioration autant qu’ll comporte un point de vigilance :
- le corpus de données utilisées croît sans cesse en taille, mais peut comporter des biais de collecte, de priorité ou d’origine (par exemple les réseaux sociaux), et les sources ne sont pas identifiées, ce qui pose un problème de fiabilité et de droits d’auteur.
- les calculs mathématiques sont organisés en couches de plus en plus nombreuses (on parle de réseau de neurones profonds ou d’apprentissage profond – deep learning) qui permettent aux pondérations d’évoluer de façon très subtile et efficace au fil de l’apprentissage, au point qu’il est devenu impossible de prédire le comportement du réseau, et donc de justifier a posteriori une décision ou une réponse.
- le choix des réponses pour le jeu de données d’entraînement (les “exercices corrigés”) n’est pas neutre et est porteur de biais cognitifs – comme le choix du corpus.
Si l’on accepte l’idée que les questions nous aident à décider, alors il est impératif d’avoir un droit de regard sur la façon dont les IA génératives y répondent. Sinon nous courons le risque – collectif – de fonder nos décisions sur le brouhaha biaisé d’une armée de perroquets stochastiques.
A la question “qu’est-ce qu’un perroquet stochastique ?”, ChatGPT répond :
(par défaut)
Un perroquet stochastique n’est pas une espèce de perroquet réelle, mais plutôt un concept humoristique ou une expression imagée. “Stochastique” fait référence à la notion de probabilité ou d’aléatoire en mathématiques et en statistiques.
Dans le contexte d’un perroquet stochastique, on pourrait imaginer un perroquet qui ne répète pas simplement les mots ou les phrases qu’il entend, mais qui les reproduit de manière aléatoire ou imprévisible. Au lieu de répéter exactement ce qu’il a entendu, il pourrait les mélanger, les transformer ou les combiner de manière inattendue.
C’est une façon humoristique de jouer avec le concept de la répétition caractéristique des perroquets en lui ajoutant un élément de surprise ou d’incertitude. Cela pourrait également être utilisé pour décrire quelqu’un qui répète des informations ou des idées de manière incohérente ou aléatoire, sans vraiment comprendre leur signification.
En résumé, le terme “perroquet stochastique” est une expression ludique qui associe l’idée d’un perroquet qui répète des mots à celle de l’imprévisibilité ou de l’aléatoire.
ChatGPT ne croit pas si bien dire !
Il est intéressant de noter que sa réponse ignore superbement l’article original de Timnit Gebru et ses co-autrices, qui lui donnaient un sens bien particulier – et péjoratif. La version originale est ici
Il semble que ce soit bien cet article qui soit à l’origine du licenciement de l’une.d’elles par Google :
-
Intelligence Artificielle et Enseignement
Une brochure très bien faite propose un panorama de l’IA et de ses usages possibles dans l’enseignement.
-
L’IA en roue libre ?
Une sélection d’articles de la presse étrangère sur les progrès récents de l’IA.
Source : Courrier International, #1695 du 27 avril au 3 mai 2023